ChatGPT, Claude yoki Gemini: oʻzbekcha matnlar uchun qaysi AI arzonroq?
Gorgona AI oʻzbek tilidagi matnlarni qayta ishlash uchun qaysi sunʼiy intellekt modeli arzonroq tushishini oʻrganib chiqdi.
Toʻqqizta model taqqoslangan tadqiqotda eng arzon va eng qimmat variantlar oʻrtasidagi tafovut qariyb 40 baravarga yetgan.
Hatto token narxi bir xil boʻlgan GPT-5.6 Sol va Claude Opus 5.5 modellarida ham xarajatlar 70 foizga farq qilgan.
Oʻzbekistonning Gorgona AI texnologiya kompaniyasi “Bir maʼno, turli narx: Sunʼiy intellekt uchun oʻzbek tili qanchaga tushadi?” nomli tadqiqotini eʼlon qildi. Unda 1 337 ta bir xil mazmundagi matn 15 ta tokenizator orqali tekshirilgan.
Tadqiqot shuni koʻrsatdiki, yirik AI kompaniyalari barcha tillar uchun bir xil token narxini belgilasa-da, oʻzbek tilidagi matnlar inglizchaga qaraganda koʻproq token egallaydi. Natijada mazmunan bir xil matnni qayta ishlash uchun yuqoriroq haq toʻlashga toʻgʻri keladi.
Token — sunʼiy intellekt matnni qayta ishlashda foydalanadigan birlik. Model matnni butun soʻzlar yoki harflar bilan emas, tokenizator ajratib beradigan boʻlaklar orqali qabul qiladi. API xizmatlarida esa haq odatda ishlatilgan tokenlar miqdoriga qarab hisoblanadi.
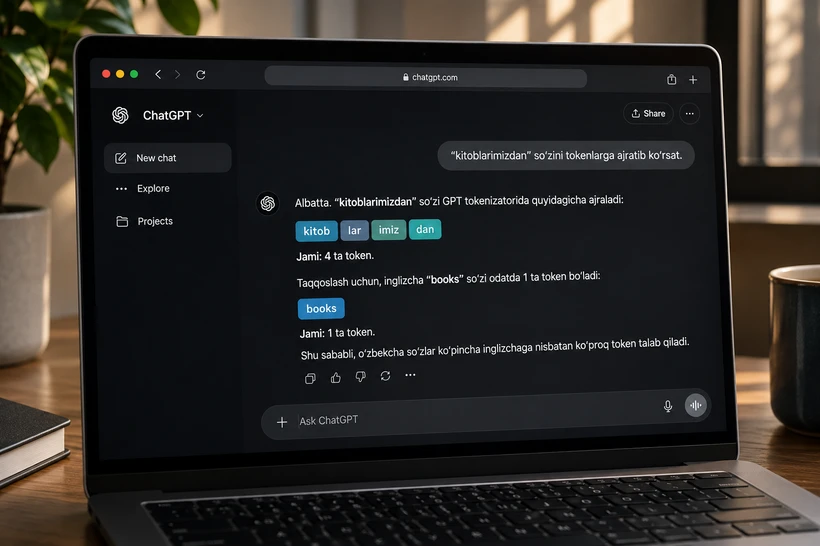
Muammo shundaki, aksariyat yirik modellarni ishlab chiqishda ingliz tilidagi maʼlumotlardan koʻproq foydalanilgan. Shu sababli inglizcha soʻzlar koʻpincha bitta tokenni egallasa, oʻzbekcha soʻzlar qoʻshimchalari bilan birga oʻrtacha deyarli uchta tokenga boʻlinadi.
Masalan, “kitoblarimizdan” soʻzi OpenAI tokenizatorida beshta tokenga ajratilishi mumkin. Bu oʻzbek tilidagi soʻzlarning tuzilishi bilan birga, tokenizator lugʻatida oʻzbekcha soʻz va qoʻshimchalarning yetarlicha aks etmagani bilan ham bogʻliq.
Qaysi AI modellari oʻzbek tiliga koʻproq token sarflaydi?
Gorgona AI’ning FLORES matnlar toʻplamidagi oʻlchovlari quyidagi natijalarni koʻrsatgan:
| AI provayderi | Inglizchaga nisbatan tokenlar |
|---|---|
| OpenAI | 1,78 baravar |
| Google Gemini 3.8 Flash | 1,90 baravar |
| Anthropic Claude | 1,93 baravar |
| Google Gemini 4 Argon | 1,95 baravar |
| Qwen | 2,04 baravar |
| DeepSeek | 2,13 baravar |
Koʻrsatkichlar bir xil mazmundagi matnning oʻzbek lotin yozuvidagi va ingliz tilidagi variantlarini taqqoslash asosida hisoblangan. Boshqa matnlar toʻplamlarida farq 1,55–2,17 baravar oraligʻida boʻlgan.
Oʻzbek tilidagi matnlar rus tiliga nisbatan ham 1,24–1,54 baravar koʻproq token talab qilgan.
Tadqiqotchilar oʻzbek tilida dastlab yozilgan matnlar bilan ingliz tilidan tarjima qilingan matnlar oʻrtasida ham farq borligini aniqlagan. Birinchi holatda qoʻshimcha xarajat nisbatan pastroq, tarjima qilingan matnlarda esa yuqoriroq boʻlgan.
Token narxi bir xil boʻlsa ham, yakuniy xarajatlar 70 foizga farq qilmoqda
Tadqiqotdagi eng qiziqarli natijalardan biri OpenAI va Anthropic modellarining taqqoslanishidir.
Gorgona AI hisob-kitoblariga koʻra, Claude Opus 5.5 va GPT-5.6 Sol modellarida million token uchun belgilangan narx bir xil boʻlgan. Biroq bir xil oʻzbekcha matnni qayta ishlashda Claude tokenizatori 70 foiz koʻproq token sarflagan.
Masalan, ingliz tilida 1 mln soʻzdan iborat matn hajmining oʻzbekcha tarjimasini qayta ishlash quyidagicha baholangan:
- Claude Opus 5.5 — 14,78 dollar;
- GPT-5.6 Sol — 8,70 dollar.
Shu sababli tadqiqotchilar kompaniyalarga AI modelini faqat million token uchun belgilangan narx asosida emas, oʻz matnlarini qayta ishlashning yakuniy qiymati boʻyicha tanlashni tavsiya qilmoqda.
Oʻzbekcha javoblar ham qimmatroq
Xarajatlar faqat sunʼiy intellektga yuboriladigan matn bilan cheklanmaydi.
Gorgona AI GPT-5.6 Luna va Claude Haiku 5.5 modellariga bir xil mazmundagi matnlarni qisqacha bayon qilish va savollarga javob berish vazifalarini bergan.
Natijada oʻzbek tilida yaratilgan koʻrinadigan javoblar ingliz tilidagiga nisbatan 1,7–1,8 baravar koʻproq xarajat talab qilgan. Bunda javoblarning belgilar soni deyarli bir xil boʻlgan.
Claude Haiku 5.5 modelida esa qoʻshimcha tafovut kuzatilgan. Model ayrim oʻzbekcha soʻrovlarga javob berishda foydalanuvchiga koʻrinmaydigan ichki mulohazalar uchun koʻproq token ishlatgan. Natijada ushbu tokenlar ham hisobga olinganda javob xarajatlari inglizchaga nisbatan 2,1–2,3 baravargacha oshgan.
Biroq tadqiqotchilar bu natija faqat tekshirilgan model va vazifalarga tegishli ekanini taʼkidlagan. Uni barcha sunʼiy intellekt modellariga tatbiq etib boʻlmaydi.
Kirill va lotin yozuvidagi xarajatlar ham farq qiladi
Tadqiqotda oʻzbek tilining kirill va lotin yozuvlari ham solishtirilgan.
Claude modellarida ikki yozuv deyarli bir xil token talab qilgan. Boshqa provayderlarda esa farq 7–23 foizgacha yetgan.
Bundan tashqari, oʻzbek lotin yozuvidagi “oʻ” va “gʻ” harflarida ishlatiladigan apostrofning turlicha yozilishi ham tokenlar soniga taʼsir qilishi aniqlangan. Apostrofning yagona shaklidan foydalanish ayrim hollarda tokenlarni 5 foizgacha tejashi mumkin.
Tadqiqotchilar oʻzbek lotin alifbosiga taklif etilgan oʻzgarishlarning taʼsirini ham hisoblab chiqqan. Unga koʻra, “oʻ”, “gʻ”, “sh” va “ch” birikmalarini mos ravishda “ö”, “ğ”, “ş” va “ç” shaklida yozish Claude, Gemini va Qwen modellarida tokenlar sonini 2–4 foizga kamaytiradi.
OpenAI va DeepSeek modellarida esa sezilarli oʻzgarish kuzatilmagan.